MIA Daily
MIA 日報:品牌團隊值得驗證的五項 AI 能力|2026 年 10 月 15 日
配音、影片、智能體上下文、執行追蹤與文件解析:從官方資料了解能力,再用具體方法判斷是否適合品牌工作。
- 引用來源
- 9
- 章節
- 8
- 語言
- EN · 繁體 · 简体 · 日本語
由文章檔案在建置時點算,不是宣稱的數字。下文每一項主張都能追到其中一個來源。
擴大使用 AI 前,先看實際工作
配音是否切合品牌語氣,影片中的產品有沒有走樣,智能體修改幾輪後還記不記得最初的要求?擴大使用 AI 前,不妨先驗證這些實際問題。本期選讀包括 Claude 的新公告、較早推出的文件解析工具,以及現有產品指南。
1. HeyGen:選好配音,先聽清楚品牌名稱
HeyGen 的聲音庫指南介紹試聽功能,以及按口音、情緒和用途篩選聲音的方法。聲音複製頁面則說明以取得同意為前提、核實聲音擁有權的流程。
**品牌團隊可以這樣試:**選一段已獲批的旁白稿,加入品牌名稱、產品用語和價格,請熟悉目標市場語言的人試聽,檢查發音、節奏與意思。聲音使用授權與稿件審批須分別確認;樣音聽起來自然,不能代替這兩項判斷。
2. Baseten 上的 Runway:生成新片與修改舊片要分開評估
Baseten 將 Runway 的 Gen-4.5列為影片生成模型,Aleph 2.0則用於編輯現有片段。兩個頁面均列明採用 Runway 專有授權。Baseten 亦另有單租戶專用部署的介紹。
**品牌團隊可以這樣試:**分別準備新鏡頭需求與團隊獲授權使用的現有片段,訂明包裝、標誌和必要文字等必須保留的內容。處理尚未公開的推廣素材前,先向供應商核實指定模型的授權與部署條款,再判斷託管方式是否合適。
3. Deep Agents:對話拉長後,請它找回最初的工作要求
LangChain 的 Deep Agents 概覽介紹了把上下文移至檔案系統的工具,以及為長對話自動製作摘要的機制。這有助管理上下文,但不代表每個細節都能準確找回。
**品牌團隊可以這樣試:**在最初的工作簡報中列出目標市場、不得使用的說法和引用來源要求。經過幾輪修改,再請智能體找回這些限制,並指出出處。與原文核對後,才決定是否繼續下一版創作。
4. Claude 執行追蹤:看清答案經過哪些步驟
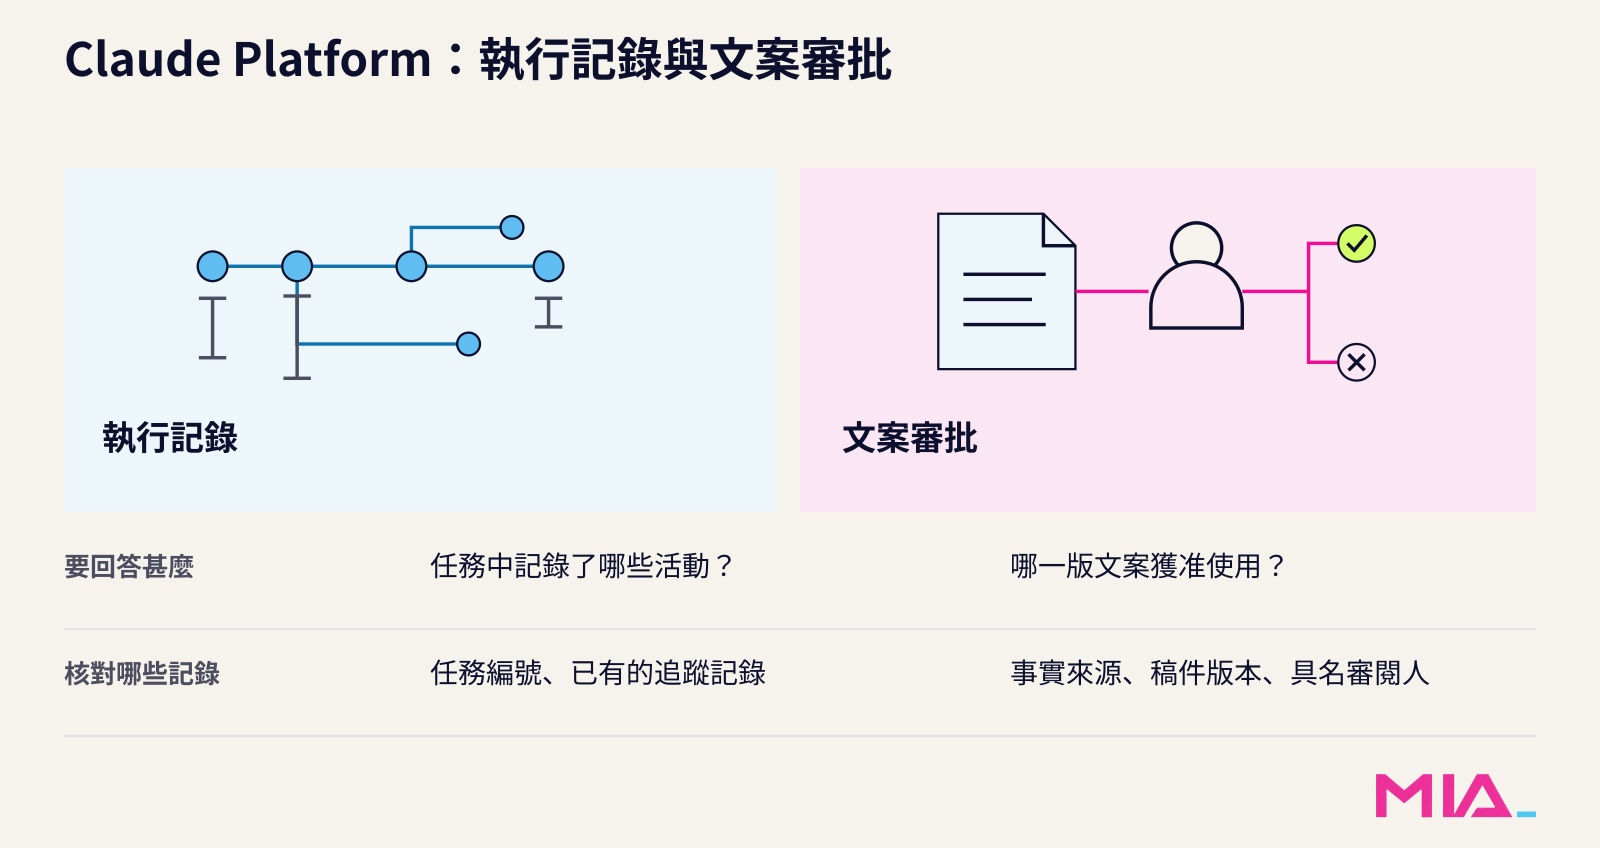
Anthropic 於 10 月 14 日宣布,Claude Platform 的 OpenTelemetry 追蹤進入公開測試,涵蓋 Managed Agents、Messages API 及 Claude SDK。公告列出的兼容工具包括 LangSmith。
**品牌團隊可以這樣試:**請技術同事檢視一次研究任務的模型呼叫、工具使用、失敗及耗時。追蹤有助理解答案如何產生,引用資料本身仍須查證。採用保密的推廣簡報前,先確認追蹤資料會傳送至哪裏,以及當中包含甚麼。
5. OpenDocRouter:用團隊日常閱讀的文件比較解析工具
LlamaIndex 於 10 月 7 日推出 OpenDocRouter,以同一個 API 接入文件解析模型。其 ParseBench 說明將表格處理、內容忠實度及格式等項目分開評估。
**品牌團隊可以這樣試:**選取少量獲准使用、包含表格、註腳與分欄的報告,把擷取的名稱和數字逐一對照原頁,記錄哪些錯誤會影響市場推廣決策。基準分數可協助初選,團隊自己的文件才是判斷是否適用的依據。
小團隊應該從哪裏開始?
先處理已有的問題:本地化影片讀錯字,就檢查發音;產品片段走樣,就檢查哪些內容必須保留;研究簡報的引用不可靠,就核對來源。用一個已獲批的樣本完成驗證,再考慮購買或接駁更多工具。
測試後應該留下甚麼?
保留原始輸入、輸出結果、審核準則,以及接受或重做的決定。下一位審稿人便有具體材料可供比較,也不會把供應商示範當成團隊自己的成果。
更多文章
繼續閱讀
看看 MIA 如何把需求書帶過 Insight、Cowork 與 IQ
本文描述的約束集合,正是 MIA IQ 在任務之間保存的東西。