MIA Daily
MIA 日报:品牌团队可以动手验证的五项 AI 能力|2026 年 10 月 15 日
从 AI 配音、视频到智能体上下文、运行追踪和文档解析,用官方资料说明能力,并为每项提供一个具体的验证办法。
- 引用来源
- 9
- 章节
- 8
- 语言
- EN · 繁體 · 简体 · 日本語
由文章文件在构建时点算,不是宣称的数字。下文每一项主张都能追到其中一个来源。
扩大 AI 使用范围前,先验证具体工作
声音是否符合品牌气质,视频里的产品有没有变样,智能体改了几轮后是否还记得最初的要求?这些都值得在扩大 AI 使用范围前先验证。本期结合 Claude 的新公告、较早发布的文档解析工具,以及当前产品指南。
1. HeyGen:选好声音后,先听品牌名
HeyGen 的声音库指南介绍了声音试听,以及按口音、情绪和用途筛选的功能。声音克隆页面则说明了以同意授权为前提、核验声音所有权的流程。
**品牌团队可以这样验证:**选一段已经批准的脚本,包含品牌名、产品术语和价格,请熟悉目标市场语言的人试听,检查发音、语速和语义。声音使用授权与脚本审批要分别确认;一段听起来流畅的样音不能替代这两项判断。
2. Baseten 上的 Runway:把生成新片段与修改旧素材分开看
Baseten 将 Runway 的 Gen-4.5列为视频生成模型,将 Aleph 2.0列为现有视频的编辑模型,两者均注明采用 Runway 专有许可。Baseten 也另行介绍了单租户专用部署。
**品牌团队可以这样验证:**分别准备一份新镜头需求和一段团队有权使用的现有视频,写清包装、标志及必要文字等不得改变的部分。用于未公开的营销素材前,向供应商核实具体模型的许可与部署条款,再判断托管方式是否适用。
3. Deep Agents:对话变长以后,检查它能否找回原始要求
LangChain 的 Deep Agents 概览介绍了将上下文移至文件系统的工具,以及压缩长对话的自动摘要。这些机制帮助管理上下文,但不保证所有细节都能准确找回。
**品牌团队可以这样验证:**在最初的任务说明里写明目标市场、禁止使用的说法,以及引用来源的要求。经过几轮修改后,请智能体找回这些原始限制并指出出处。将回答与原文对照,再决定是否进入下一版创作。
4. Claude 运行追踪:查看答案背后的执行步骤
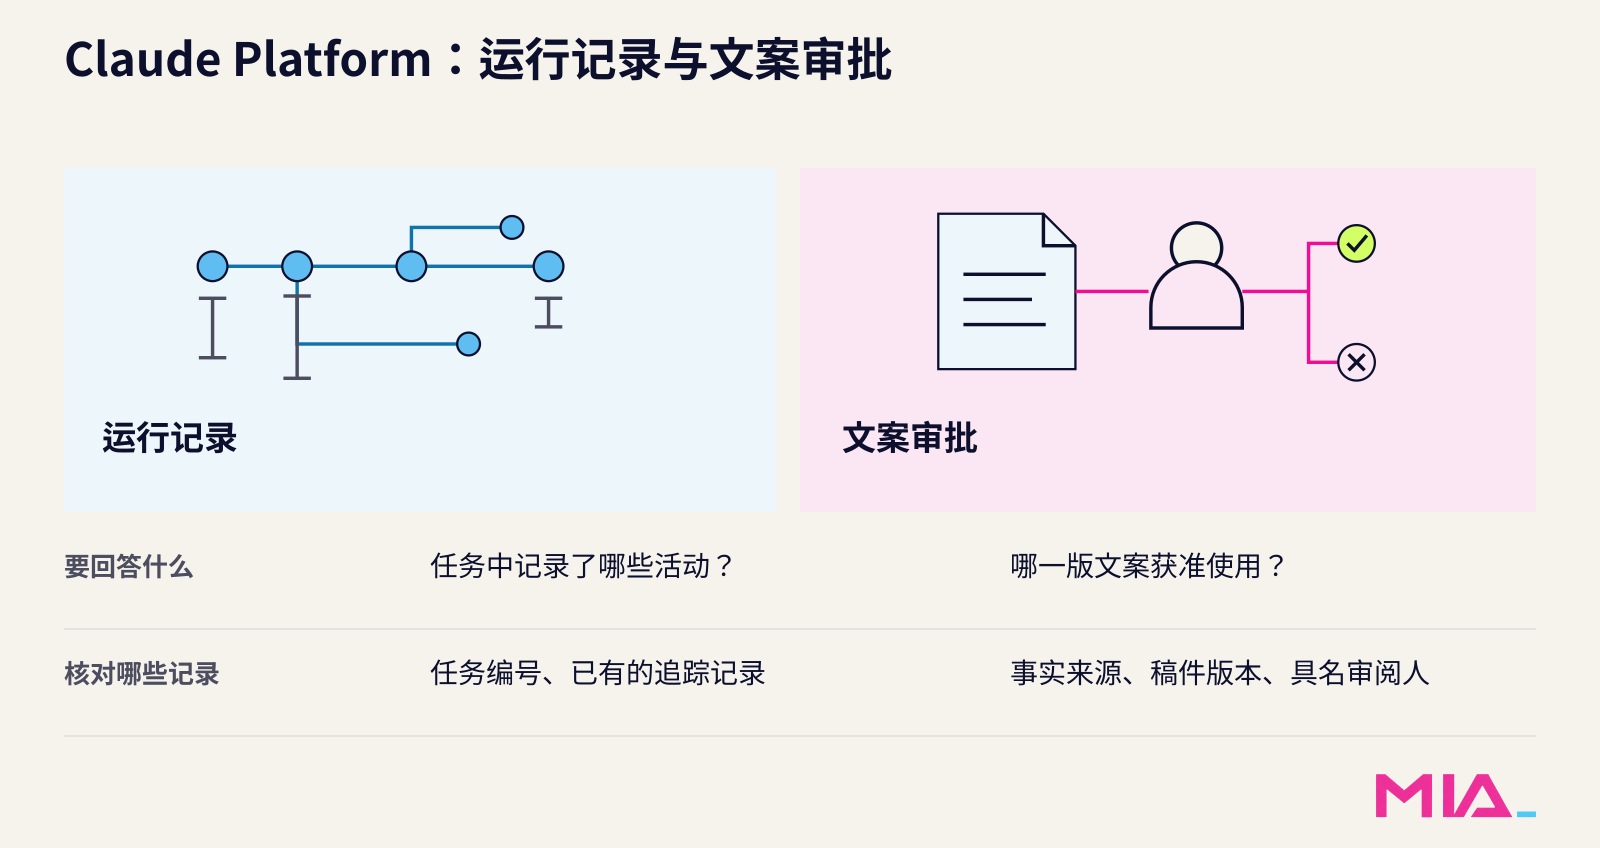
Anthropic 于 10 月 14 日宣布,Claude Platform 的 OpenTelemetry 追踪进入公开测试,涵盖 Managed Agents、Messages API 和 Claude SDK。公告将 LangSmith 列为兼容工具之一。
**品牌团队可以这样验证:**请技术同事查看一次研究任务中的模型调用、工具调用、失败与耗时。追踪记录有助于解释答案如何产生,引用材料本身仍需核验。使用保密的营销任务说明前,先检查追踪数据会被发送到哪里、包含什么。
5. OpenDocRouter:用团队真正要读的文档比较解析器
LlamaIndex 于 10 月 7 日推出 OpenDocRouter,以同一个 API 接入文档解析模型。其 ParseBench 说明将表格处理、内容忠实度和格式等维度分别评估。
**品牌团队可以这样验证:**挑选少量获准使用、包含表格、脚注和分栏排版的报告,将提取的名称和数字逐一对照原始页面,记录哪些错误会影响营销判断。基准分数可以帮助初筛,自己的文档才决定工具能否投入使用。
小团队应该从哪一项开始?
从已经遇到的问题开始:本地化视频读错词,就检查发音;产品视频被改样,就检查保留内容;研究简报的引用不可靠,就检查来源。先用一个已批准的样本完成验证,再考虑购买或接入更多工具。
验证后应该保留什么?
保留原始输入、生成结果、审核标准,以及接受或返工的决定。下一位审核者因此有具体材料可以比较,也不会把供应商的演示当成团队自己的成效。
看看 MIA 如何把需求书带过 Insight、Cowork 与 IQ
本文描述的约束集合,正是 MIA IQ 在任务之间保存的东西。